Thử gõ câu “Con ngựa đá con ngựa đá” vào một công cụ dịch. Người Việt nào cũng hiểu câu này có thể là con ngựa (bằng) đá đá con ngựa (thật), hoặc ngược lại. Máy thì thường bối rối.
Tiếng Việt là một thứ tiếng thú vị với máy tính, theo cả nghĩa tốt lẫn nghĩa xấu. Câu chuyện máy học tiếng Việt cũng là câu chuyện về chính đặc điểm của tiếng mẹ đẻ của chúng ta.
Dấu cách không phải ranh giới của từ
Trong tiếng Anh, mỗi khoảng trắng gần như ngăn cách hai từ. Tiếng Việt thì khác: khoảng trắng ngăn cách các âm tiết. “Đất nước”, “máy tính”, “học sinh” là những từ hai âm tiết, nhưng nhìn bề ngoài, chúng giống hệt hai từ rời.
Câu “học sinh học sinh học” là ví dụ kinh điển: phải hiểu nghĩa mới biết tách thành “học sinh / học / sinh học”. Bài toán tách từ này từng là một trong những thử thách đầu tiên của các nhóm nghiên cứu xử lý ngôn ngữ tiếng Việt từ những năm 2000.
Sáu thanh điệu và những dấu mũ
“Ma, má, mà, mả, mã, mạ”: chỉ khác một dấu, nghĩa đã khác hẳn. Thêm các chữ cái có mũ, có râu như ă, â, ê, ô, ơ, ư, đ, tiếng Việt có một hệ thống ký tự phức tạp hơn nhiều ngôn ngữ dùng chữ Latinh khác.
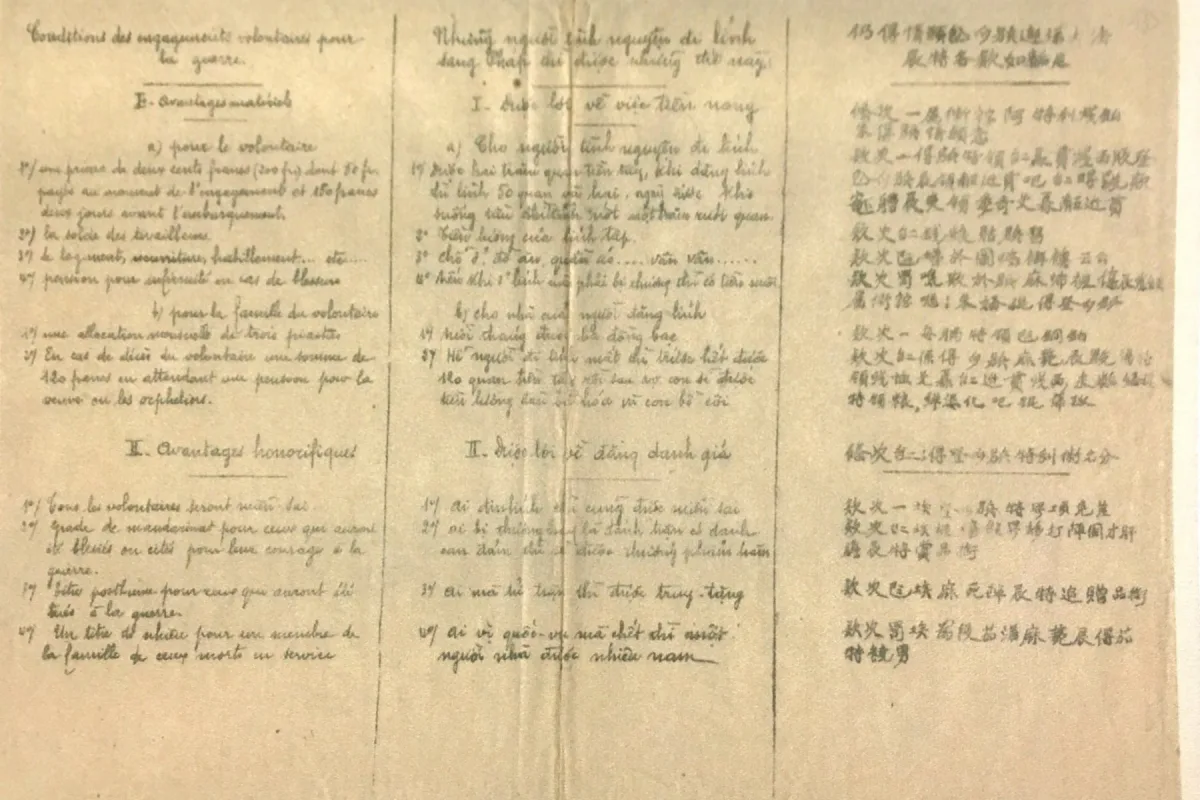
Những người dùng máy tính từ cuối thập niên 1990 hẳn còn nhớ thời “loạn bảng mã”: VNI, TCVN3 (ABC), VIQR… Văn bản soạn ở máy này mở sang máy khác thành một mớ ký tự lạ. Phải đến khi Unicode trở thành chuẩn chung, cùng với các bộ gõ miễn phí như Unikey, chuyện này mới dần chấm dứt.
Với các mô hình AI, dấu thanh vẫn là chuyện không đơn giản. Nhiều người Việt nhắn tin không dấu, nên dữ liệu trên mạng lẫn lộn cả hai kiểu. Một mô hình phải học được rằng “toi di hoc” và “tôi đi học” là cùng một câu, nhưng “ban” có thể là bạn, bán, bàn hay bản.
Ít dữ liệu hơn tiếng Anh, nhưng không ít
Tiếng Việt có khoảng một trăm triệu người nói, nằm trong nhóm hai mươi ngôn ngữ đông người dùng nhất thế giới. Tuy vậy, lượng văn bản tiếng Việt chất lượng cao trên Internet vẫn chỉ bằng một phần rất nhỏ so với tiếng Anh.
Điều này giải thích vì sao các chatbot đời đầu nói tiếng Việt khá “Tây”: câu đúng ngữ pháp nhưng cứng, dùng từ như dịch máy, xưng hô lúng túng. Máy rất khó biết khi nào nên nói “anh”, “chị”, “em”, “bác”, vì điều đó phụ thuộc vào tuổi tác, quan hệ, vùng miền, những thứ không nằm trong câu chữ.
Người Việt tự làm AI cho tiếng Việt
Các nhóm nghiên cứu trong nước đã đi những bước đáng kể. Năm 2020, VinAI công bố PhoBERT, một trong những mô hình ngôn ngữ đầu tiên được huấn luyện riêng cho tiếng Việt, trở thành nền tảng cho nhiều nghiên cứu sau này. Các trường đại học, các công ty như Viettel, FPT, VNG, Zalo cũng phát triển những mô hình và trợ lý ảo tiếng Việt của riêng mình.
Các mô hình lớn của thế giới cũng tiến bộ rất nhanh. Chỉ vài năm trước, chatbot còn dịch “mưa phùn” thành những câu ngô nghê. Nay nhiều mô hình đã viết được thơ lục bát đúng luật, hiểu được tiếng lóng của giới trẻ và phân biệt được giọng Bắc với giọng Nam trong văn bản.
Những gì máy vẫn chưa hiểu
Dù vậy, có những lớp nghĩa mà máy vẫn chật vật. Câu ca dao “Thương nhau cởi áo cho nhau, về nhà dối mẹ qua cầu gió bay” không chỉ là chuyện chiếc áo. Một tiếng “dạ” của người miền Nam, một chữ “ừ” trống không trong tin nhắn, hay câu “thôi được rồi” của người yêu đều mang những sắc thái mà chỉ người trong cuộc mới hiểu.
Ngôn ngữ không chỉ là chữ. Nó là cách một cộng đồng nhìn thế giới. Máy có thể học được chữ rất nhanh, nhưng cách nhìn thì cần nhiều thời gian hơn.
Có lẽ vì thế mà mỗi lần AI viết sai một câu tiếng Việt, người Việt chúng ta lại có dịp nhận ra tiếng mẹ đẻ của mình tinh tế đến mức nào.
Bình luận (0)
Chưa có bình luận nào. Hãy là người đầu tiên!